
Modelo de Avaliação de Maturidade de Segurança em Aplicações
Descubra como avaliar a maturidade de segurança em aplicações web e mobile de forma objetiva utilizando inteligência artificial e o CVSS.
Modelo de Avaliação de Maturidade de Segurança em Aplicações
Descubra como avaliar a maturidade de segurança em aplicações web e mobile de forma objetiva utilizando inteligência artificial e o CVSS.
Este artigo propõe um modelo quantitativo e objetivo utilizando algoritmos de aprendizagem de máquina supervisionada para avaliar a maturidade de segurança de aplicações com base no CVSS das vulnerabilidades identificadas em projetos de pentest. O modelo é composto por dois submodelos: um para o ajuste na classificação da severidade das vulnerabilidades e outro para a avaliação da maturidade de segurança dos projetos de pentest como um todo. A pesquisa utilizou uma base de dados anonimizada de vulnerabilidades e projetos reais. Os resultados indicam que o modelo proposto pode ser uma ferramenta eficaz para a classificação de vulnerabilidades e para a avaliação da maturidade de segurança de aplicações em um contexto empresarial.
1. Introdução
Na atual era digital, existe uma crescente dependência da utilização de sistemas de informação e aplicações digitais. Com isso, os ataques cibernéticos migram do âmbito físico para o digital, representando uma ameaça constante para os usuários e para as empresas que desenvolvem e/ou disponibilizam tais sistemas. Com o aumento da frequência e sofisticação desses ataques, as empresas enfrentam o desafio constante de proteger seus ativos contra ameaças que estão sempre em evolução, sejam essas ameaças internas ou externas, tornando a avaliação e o aprimoramento da sua postura de segurança algo imprescindível. Devido a isso, a segurança da informação se torna uma peça fundamental para garantir a integridade, confidencialidade e disponibilidade dos dados, como também é um dos pilares fundamentais para o sucesso e a sustentabilidade das organizações em um ambiente digital cada vez mais complexo e interconectado.
Os testes de penetração, ou pentests, tornaram-se uma prática essencial para identificar possíveis vulnerabilidades e avaliar a resistência dos sistemas a ataques simulados. No entanto, a simples identificação de vulnerabilidades não é suficiente para garantir a segurança eficaz de uma organização, visto que é necessário desenvolver e aplicar as correções para cada vulnerabilidade encontrada. No entanto, a classificação técnica relativa à priorização das vulnerabilidades de forma individual não é tão efetiva para a alta gestão. É necessário compreender a gravidade e o potencial impacto dessas vulnerabilidades na segurança geral do ambiente para que ações estratégicas de negócio sejam tomadas de forma eficiente.
Atualmente, é comum empresas solicitarem uma avaliação da maturidade de segurança de suas aplicações ou escopos alvo a partir de um pentest. Essa avaliação necessita ser expressa, inicialmente, em uma escala quantitativa (de 0 a 10), para que seja possível expressá-la em uma escala objetiva (maturidade baixa, aceitável ou alta). No entanto, não existe um padrão universalmente aceito para determinar essa pontuação, o que pode levar a interpretações subjetivas e inconsistências nos resultados. Pode-se afirmar que tal padrão é difícil de ser atingido devido aos diversos tipos de negócio existentes (sistemas voltados para o setor financeiro, hospitalar, para armazenamento e proteção de dados, entre outros) ou até mesmo devido a legislações de países, onde uma mesma vulnerabilidade poderá ter “peso” distinto para cada situação.
É bastante comum fazer uso do CVSS (Common Vulnerability Scoring System) como um classificador de maturidade de segurança, visto que o sistema é uma estrutura bem estabelecida e amplamente utilizada para avaliar a gravidade das vulnerabilidades, levando em consideração os três principais pilares da segurança da informação — confiabilidade, integridade e disponibilidade — bem como outros fatores, como por exemplo: privilégio necessário e complexidade de exploração de tal vulnerabilidade. Porém, o CVSS possui apenas o intuito de dar uma nota para cada vulnerabilidade de forma separada, não realizando uma avaliação completa, por exemplo, combinando duas ou mais vulnerabilidades, do ambiente testado.
Nesse contexto, este trabalho propõe o desenvolvimento de um modelo quantitativo e objetivo utilizando algoritmos de aprendizagem de máquina supervisionada para avaliar a maturidade de segurança de aplicações com base no CVSS das vulnerabilidades identificadas em pentests.
O modelo proposto visa preencher uma lacuna existente nas práticas de segurança das empresas, fornecendo uma abordagem padronizada e transparente para avaliar a maturidade de segurança das aplicações. Ao integrar o CVSS em um framework de avaliação de maturidade, espera-se oferecer uma ferramenta direta e de fácil utilização para medir a maturidade de segurança das aplicações como um todo, destacando-se por não visar apenas vulnerabilidades de forma individual. Essa integração permite uma visão mais abrangente e contextualizada da segurança, considerando tanto as vulnerabilidades isoladas quanto a interação e o impacto delas em conjunto no contexto geral da aplicação e de sua regra de negócio.
2. Referenciais Teóricos
2.1 Segurança da informação
A segurança da informação envolve uma variedade de conceitos e princípios destinados a proteger os dados e sistemas de informação contra ameaças, como: acesso não autorizado, uso indevido, alteração, destruição de dados ou simplesmente o impedimento do seu uso. A base dos conceitos da segurança da informação é formada a partir de três pilares:
- Confidencialidade: Garante que as informações sejam acessadas apenas por pessoas autorizadas. Isso é geralmente alcançado por meio de criptografia, controle de acesso e políticas de segurança. Por exemplo, apenas o portador do dado conseguirá acessar tais dados, como CPF, cartão de crédito, resultado de exame, entre outros.
- Integridade: Garante que as informações não sejam alteradas de forma não autorizada. Técnicas como assinaturas digitais e hashes criptográficos são usadas para verificar a integridade dos dados. Por exemplo, os hashes criptográficos são usados para verificar se os dados foram alterados inadvertidamente ou intencionalmente.
- Disponibilidade: Garante que as informações estejam acessíveis quando necessário. Isso envolve a implementação de medidas para prevenir ataques de negação de serviço (DoS), falhas de hardware e software, bem como garantir redundância e backup dos sistemas. Por exemplo, a implementação de sistemas de tolerância a falhas e a replicação de dados pode garantir a disponibilidade contínua dos serviços de informação.
A segurança da informação está em alta na atualidade por várias razões. É notável o crescimento dos ataques contra as aplicações web a partir de 2007. Tal fato pode ser comprovado hoje em dia devido aos seguintes fatores:
- Crescente dependência da tecnologia: Com a crescente dependência da tecnologia em praticamente todos os aspectos da vida pessoal e empresarial, os dados se tornaram um dos ativos mais valiosos. Isso torna os sistemas de informação alvos atrativos para criminosos cibernéticos e outras ameaças.
- Aumento das ameaças cibernéticas: As ameaças cibernéticas estão se tornando mais sofisticadas e generalizadas. Ataques como ransomware, phishing, e ataques de negação de serviço estão se tornando cada vez mais comuns e impactantes.
- Regulamentações e compliance: Regulamentações governamentais, como GDPR na União Europeia e LGPD no Brasil, estão impondo requisitos mais rigorosos para proteção de dados pessoais. Isso obriga as organizações a implementarem medidas mais robustas de segurança da informação para garantir a conformidade.
- Impacto nos negócios: Incidentes de segurança cibernética podem ter um impacto significativo nos negócios, incluindo perda financeira, danos à reputação, interrupção das operações e litígios. Portanto, as organizações estão cada vez mais conscientes da importância de investir em segurança da informação como uma medida preventiva.
- Inovação tecnológica: Com a rápida inovação tecnológica, novas ameaças e vulnerabilidades estão constantemente surgindo. As organizações precisam acompanhar essas mudanças e adotar medidas de segurança adequadas para proteger seus ativos de informação.
2.2 Common Vulnerability Scoring System
O CVSS (Common Vulnerability Scoring System) é um sistema de pontuação padronizado usado para avaliar a gravidade das vulnerabilidades de segurança em sistemas de computadores. Ele fornece uma métrica quantitativa para ajudar na priorização e tratativas de mitigação de vulnerabilidades, permitindo que as organizações avaliem o risco associado a uma determinada vulnerabilidade de forma consistente. Atualmente a versão mais recente é a 4.0. Porém, optou-se por não utilizar a versão 4.0, introduzida em novembro de 2023, devido à sua utilização ainda limitada por parte das empresas e seus sistemas. Embora a versão 4.0 apresente melhorias e atualizações significativas em relação às versões anteriores, a falta de ampla implementação e familiaridade no mercado poderia comprometer a relevância e utilização dos resultados deste trabalho. Devido a este fato, foi utilizada a versão 3.1 do CVSS lançada em junho de 2019, garantindo ao modelo gerado uma maior consistência nos resultados.
O CVSS 3.1 é composto de três grupos de métricas, sendo eles: Base, Temporal, e Environmental. Para este trabalho em questão, vamos restringir o uso do CVSS apenas no grupo de métricas Base, que é a métrica adotada pelo mercado devido a sua baixa complexidade de compreensão e utilização, bem como métrica obrigatória para o sistema. Os grupos Temporal e Environmental são opcionais para utilização do CVSS.
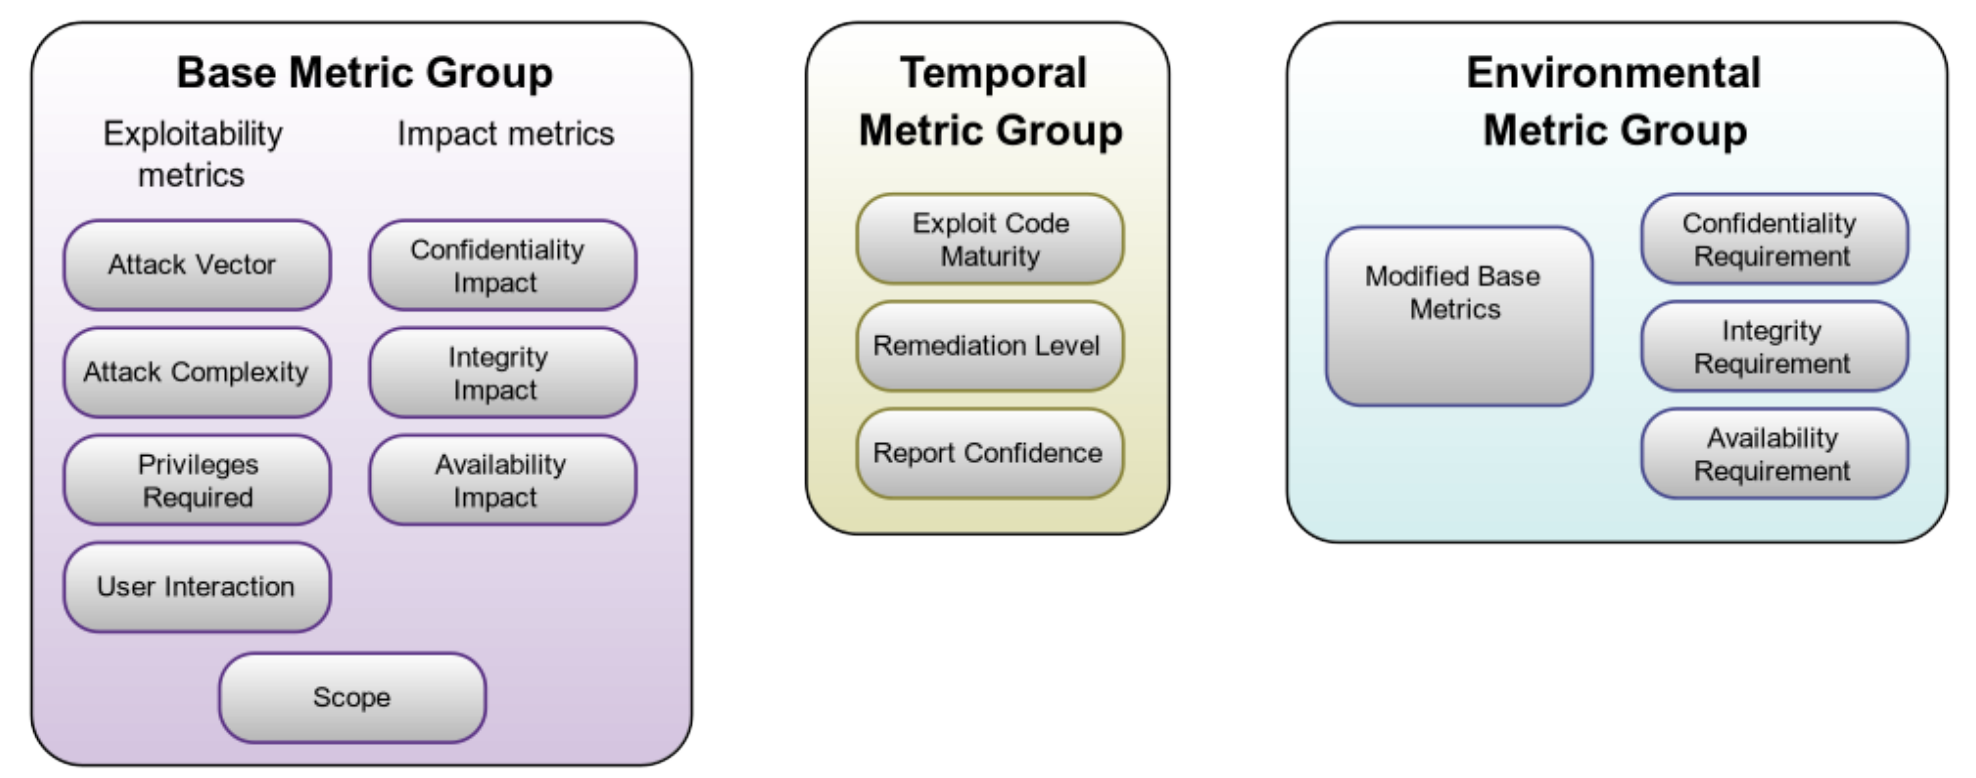
O Base Metric Group do CVSS 3.1 é composto por três pilares bases:
- Exploitability metrics;
- Impact metrics;
- Scope;
As Exploitability metrics tem a função de avaliar a facilidade com que uma vulnerabilidade pode ser explorada. Essa métrica considera diversos fatores, como: o vetor de ataque (denominado attack vector – AV), a complexidade (denominado complexity – C) para realizar o ataque, privilégios necessários (denominado privileges required – PR) e a interação do usuário (denominado user interaction – UI).
As Impact metrics se resumem no impacto da vulnerabilidade nos pilares da segurança da informação: Impacto da Confidencialidade (C), Impacto da Integridade (I) e Impacto da Disponibilidade (A).
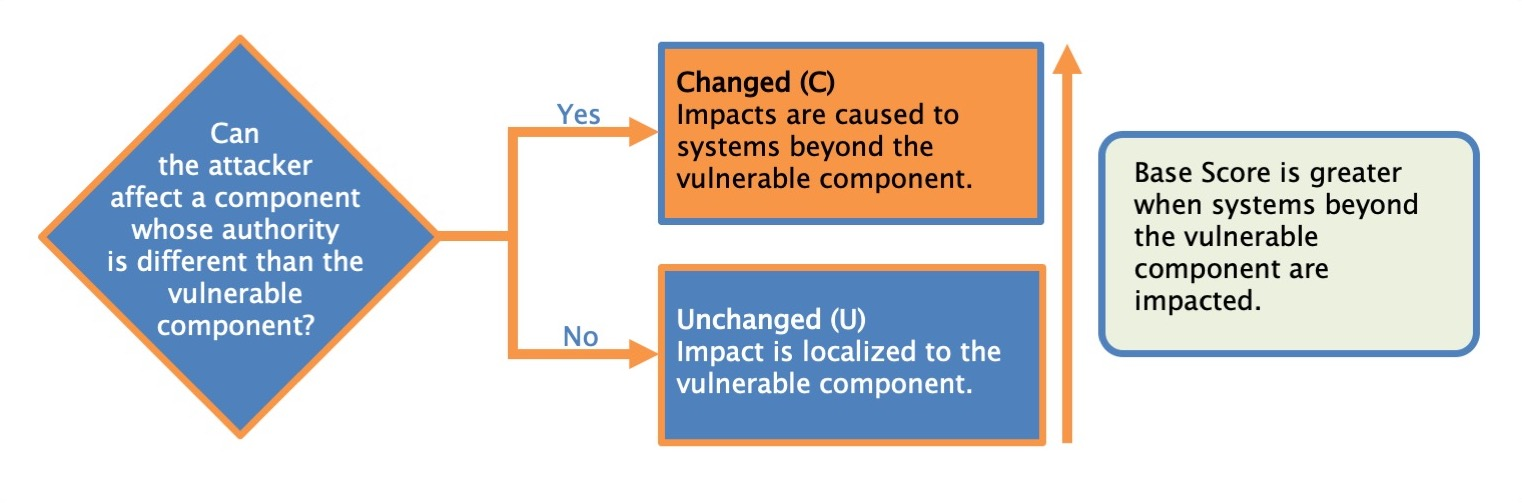
Já o Scope tem o intuito classificar se uma vulnerabilidade em um componente vulnerável impacta recursos em componentes além de seu escopo de segurança.
O cálculo desses fatores resulta em uma pontuação — numa escala de 0 a 10, onde 0 representa nenhum impacto e 10 representa o impacto máximo — que ajuda a determinar a criticidade da vulnerabilidade, permitindo que as organizações utilizem dessa pontuação como forma de priorizar suas ações de mitigação e correção. Além disso, o preenchimento de tais métricas também gera insumo para o Vector String, que é uma representação textual dos valores métricos usados para pontuar a vulnerabilidade.
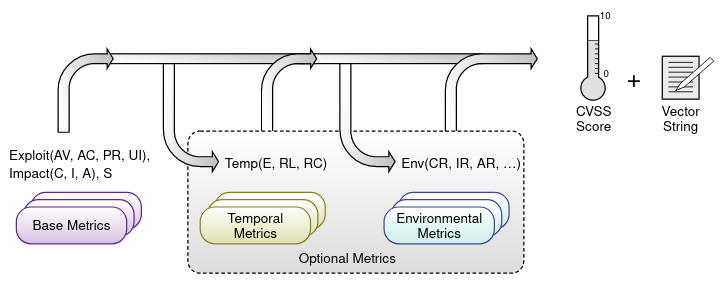
As Exploitability metrics refletem as características daquilo que é vulnerável, onde cada uma das métricas necessita ser pontuada em relação ao componente vulnerável e refletir as propriedades da vulnerabilidade que levam a um ataque bem-sucedido.
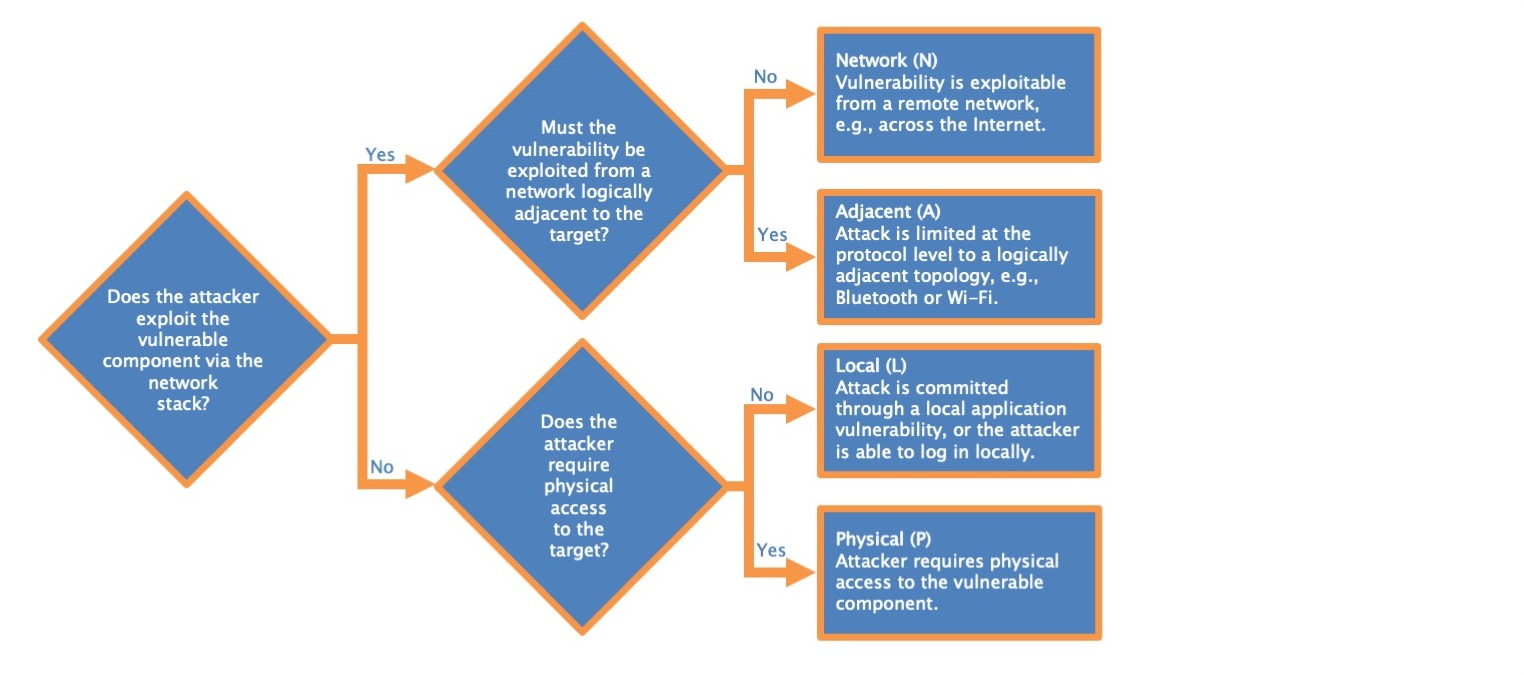
- Attack Vector (AV): indica a partir de onde a vulnerabilidade pode ser explorada.
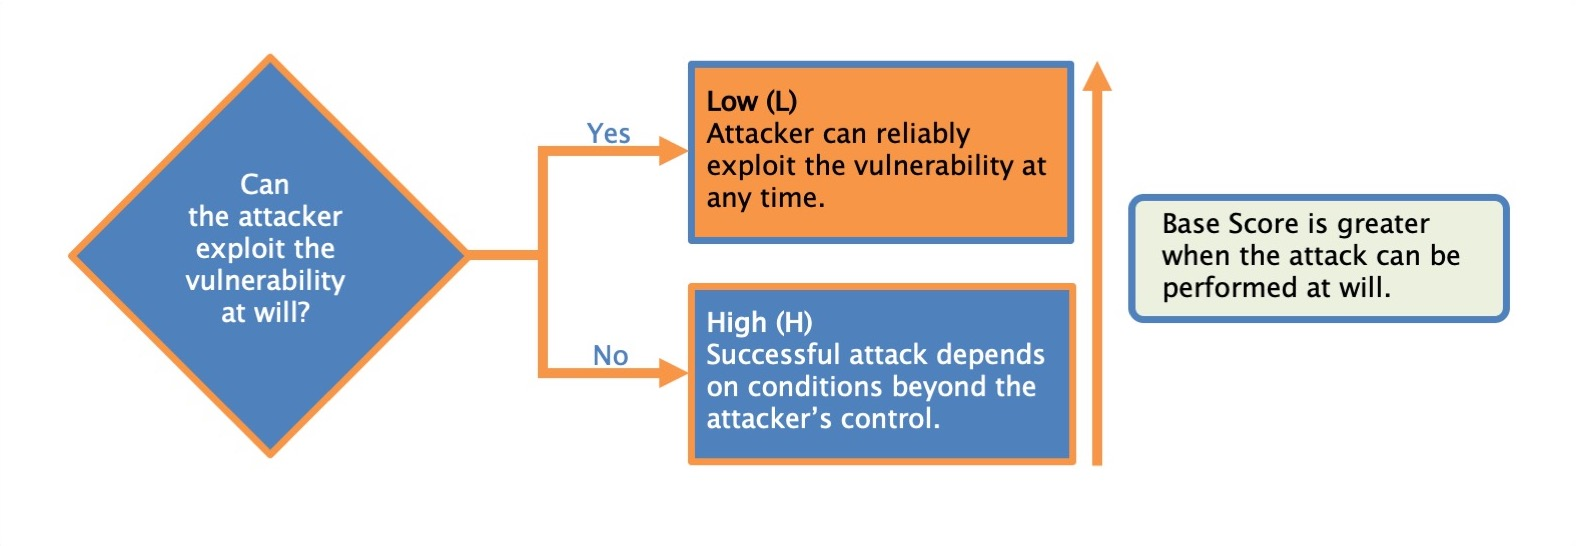
- Attack Complexity (AC): detalha as condições externas ao controle do atacante que são necessárias para a exploração da vulnerabilidade. Isso inclui fatores como o esforço e tempo necessários para executar o ataque, bem como a possibilidade de precisar combinar outras vulnerabilidades para explorar a vulnerabilidade atual de forma efetiva.
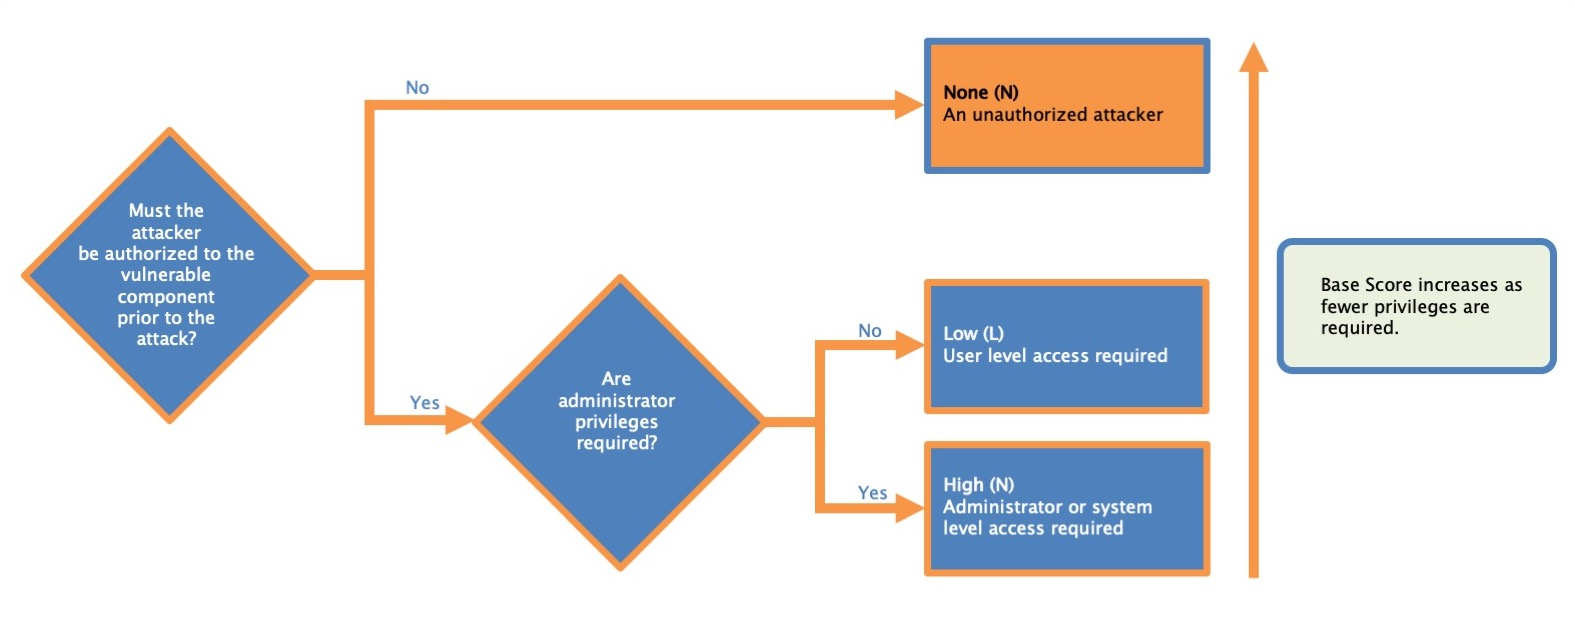
- Privileges Required (PR): mede o nível de privilégios necessários para um ataque bem-sucedido.
- User Interaction (UI): indica se é necessária a interação de um usuário para que a vulnerabilidade.
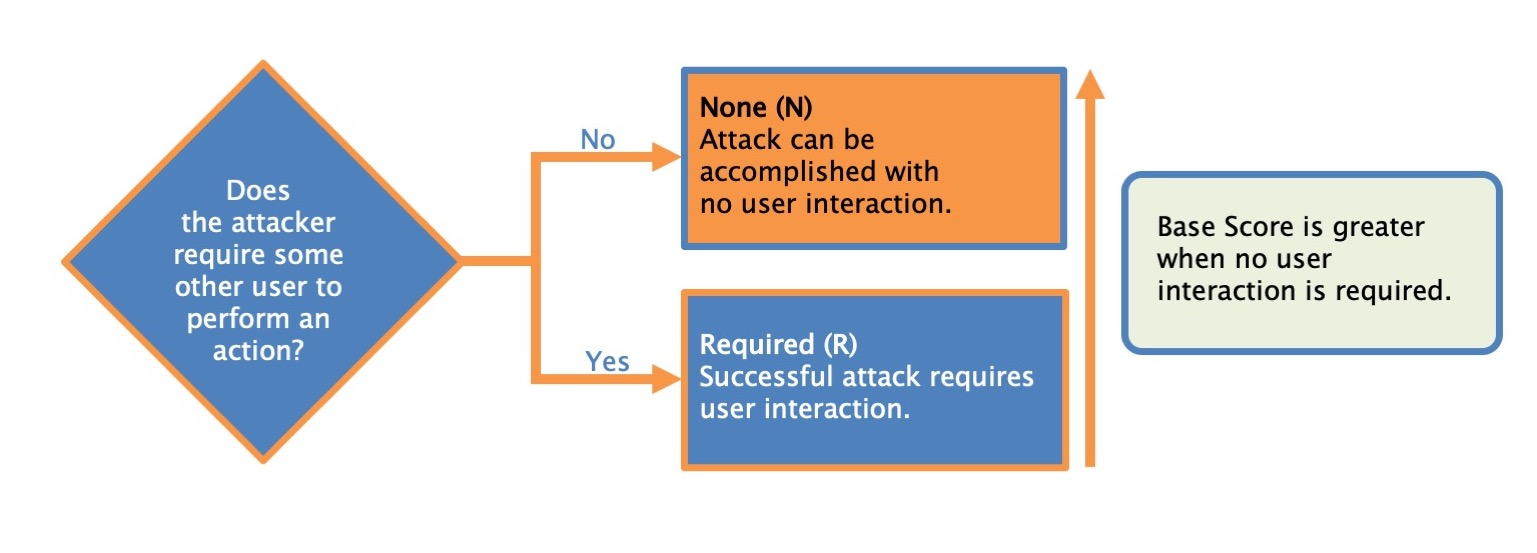
Já as Impact metrics capturam os efeitos de uma vulnerabilidade explorada com sucesso no componente que sofre o pior resultado, que está mais diretamente e previsivelmente associado ao ataque, como por exemplo qual nível de impacto na integridade dos dados a partir da vulnerabilidade.
- Confidentiality (C): mede o impacto na confidencialidade dos dados ao explorar uma vulnerabilidade com sucesso, dando acesso a dados confidenciais a um atacante.
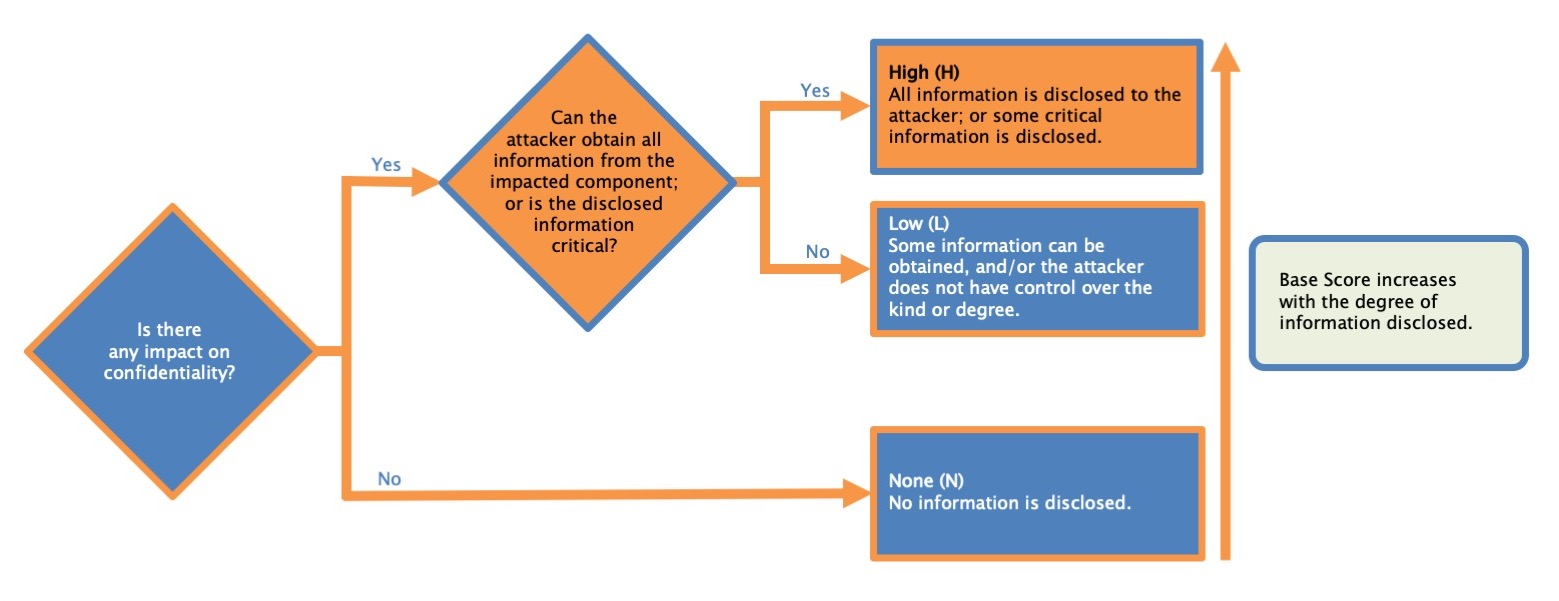
- Integrity (I): mede o impacto na integridade dos dados ao explorar uma vulnerabilidade com sucesso, permitindo que um atacante modifique dados confidenciais.
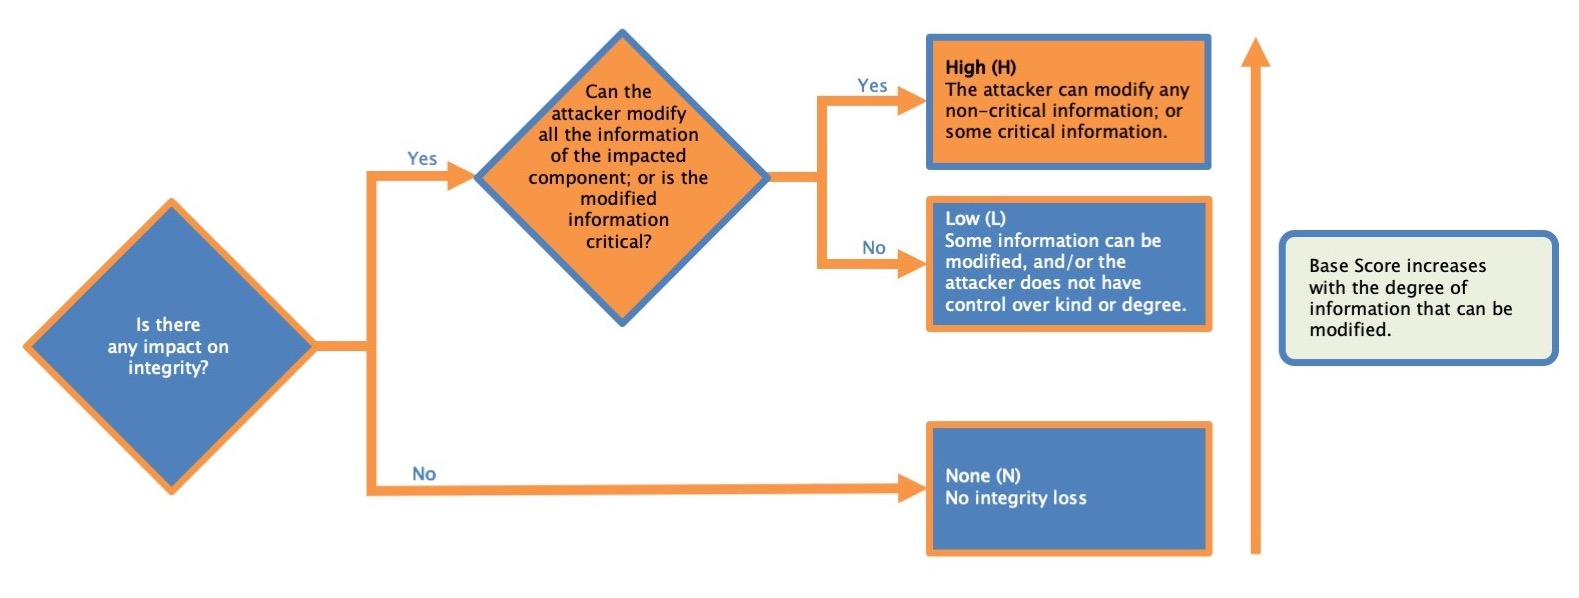
- Availability (A): mede o impacto na disponibilidade dos dados ao explorar uma vulnerabilidade com sucesso, impossibilitando o acesso a serviços, dados, ou recursos do componente impactado.
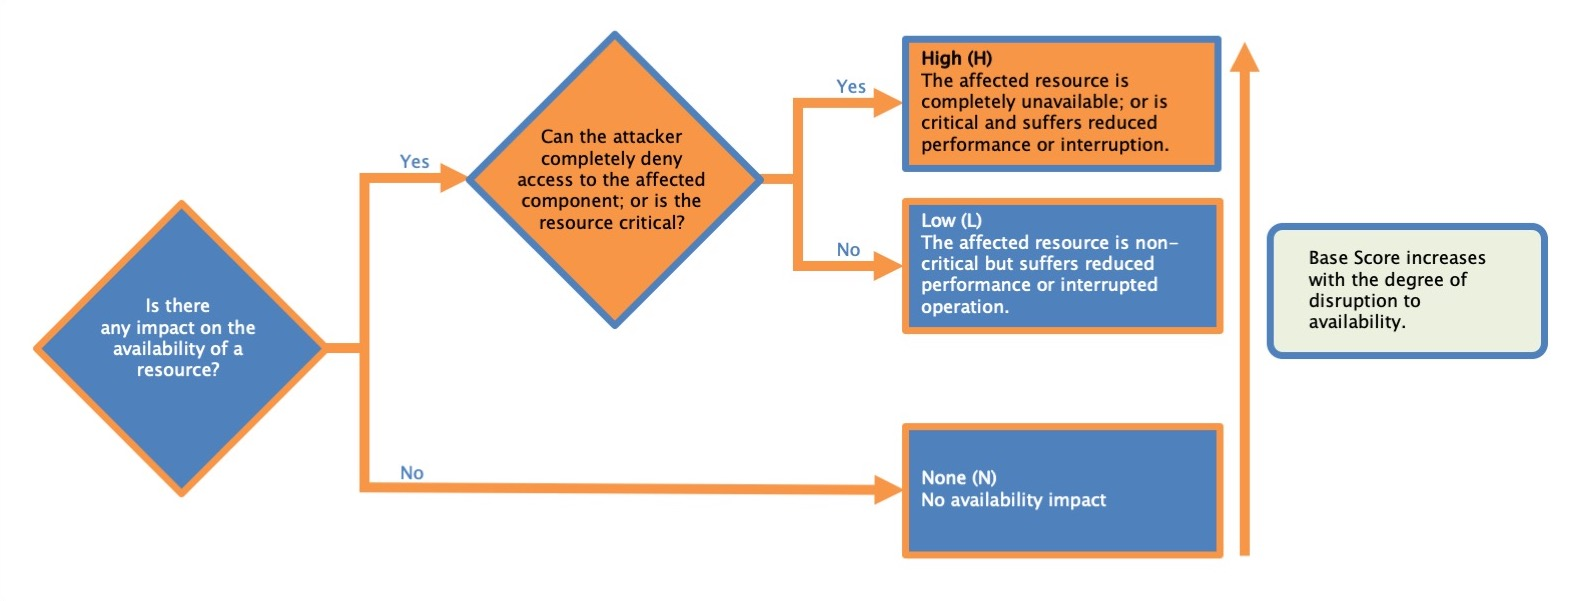
Por fim, o Scope possibilita diferenciar vulnerabilidades em que o impacto recai sobre o componente vulnerável ou sobre um componente distinto, denominado por componente impactado.
Por ser uma ferramenta de pontuação com um padrão que é utilizado mundialmente, é comum que as organizações utilizem desse recurso para “avaliar e priorizar adequadamente os seus processos de gestão de vulnerabilidades”. Entretanto, de acordo com Spring e Hatleback no artigo Time to change the CVSS? [Spring et al. 2021], as organizações que fazem esse tipo de uso estão condenadas a não ter resultados confiáveis. A própria especificação do CVSS explicita que fazer uso do CVSS de forma isolada diretamente como pontuação de risco é um erro. Uma prova disso se dá no seguinte exemplo:
Supondo um cenário fictício de um comércio eletrônico (e-commerce) onde esta loja virtual oferece uma ampla gama de produtos e serviços, desde eletrônicos até itens de moda. A aplicação está disponível e exposta publicamente na Internet, sendo possível acessá-la de qualquer localidade. Os clientes podem criar contas para realizar compras mais facilmente e receber atualizações sobre promoções e ofertas. Para realizar uma compra na aplicação, é necessário que a pessoa compradora realize um cadastro informando seu nome, CPF, e-mail, senha, e um cartão de crédito. Uma vez efetuado o cadastro, a organização passará a ter tais dados armazenados.
Entretanto, existe uma vulnerabilidade na aplicação em questão, mais especificamente no sistema responsável pelo armazenamento e gerenciamento de dados dos usuários. Uma vez que a vulnerabilidade seja explorada através de um exploit¹ ou manualmente, é possível acessar as informações inseridas no cadastro (como nome completo, CPF, endereço de e-mail, hash de senha e até mesmo números de cartão de crédito dos clientes) de outros usuários da loja virtual. Para isso, basta submeter o ID relativo a algum usuário, e neste cenário, esse ID é um número inteiro positivo e incremental. Tal vulnerabilidade, neste cenário, é conhecida como Insecure Direct Object Reference (IDOR)² ou Escalação Horizontal de Privilégios³. Como agravante, é possível automatizar as requisições HTTP para realizar a captura das informações em grande escala.
Baseado neste cenário, podemos utilizar da calculadora criada pela F1rst — https://www.first.org/cvss/calculator/3.1 — para aferir os valores relativos ao CVSS, sendo eles o valor da nota (CVSS Score) e sua representação textual (CVSS String). A figura 11 demonstra os campos preenchidos de acordo com o cenário descrito e logo em seguida a descrição da seleção de cada campo:
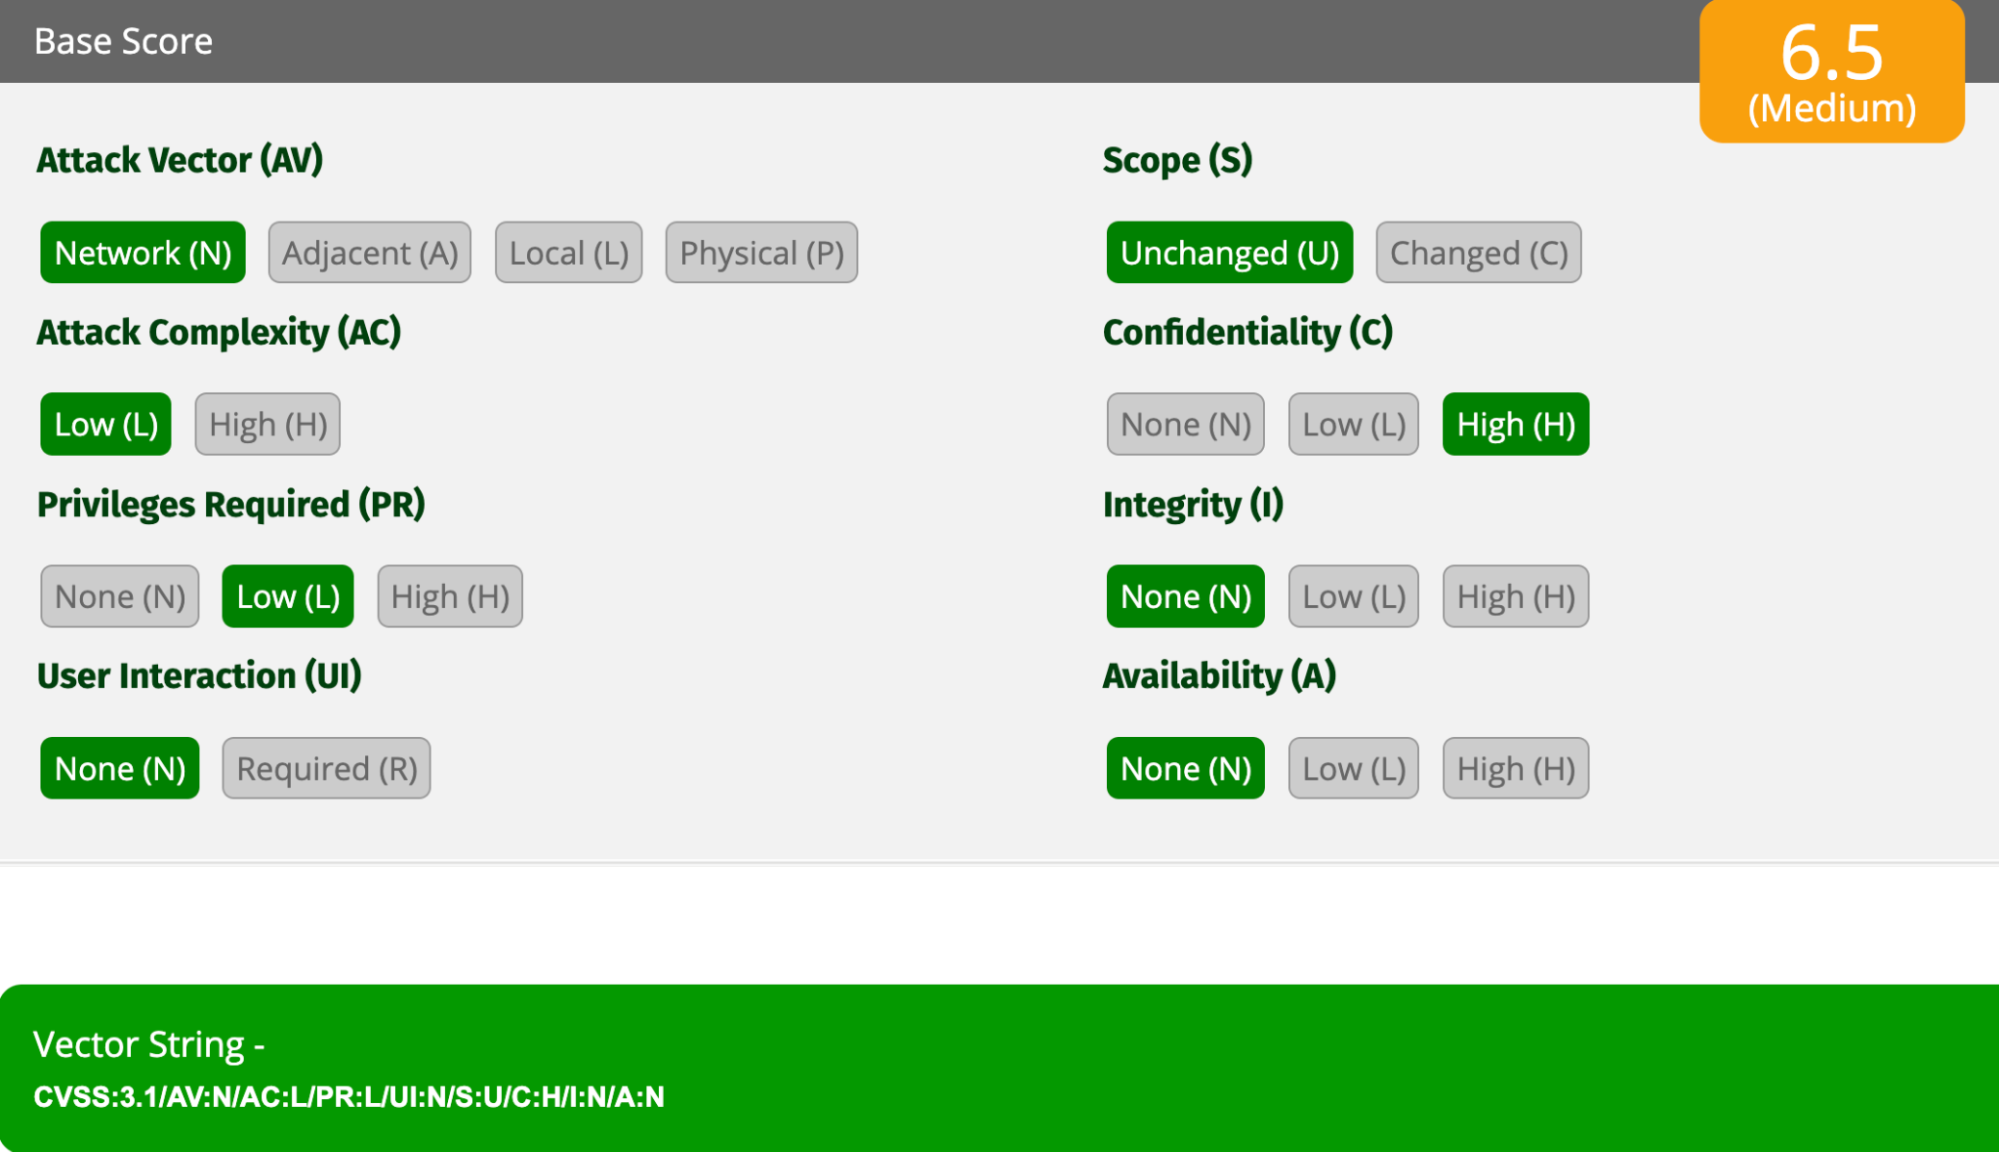
- Attack Vector (AV) – Network: a aplicação está disponível para toda Internet;
- Attack Complexity (AC) – Low: é necessário apenas submeter um número inteiro positivo no parâmetro da requisição de buscar as informações de um usuário;
- Privileges Required (PR) – Low: é necessário o usuário estar autenticado na aplicação e a aplicação permite o autocadastro;
- User Interaction (UI) – None: a vítima não necessita ter interação alguma com o atacante sendo necessário apenas que a vítima já tenha feito o cadastro na aplicação em algum momento antes do ataque ser efetuado;
- Scope – Unchanged: o ataque não sai do contexto da aplicação, não sendo acessado, por exemplo, o banco de dados diretamente ou o computador/celular da vítima;
- Confidentiality – High: há um comprometimento total da confidencialidade dos dados, uma vez que o atacante terá acesso as todas as informações cadastrais da vítima bem como o acesso irrestrito e indevido;
- Integrity – None: os dados não são modificados, apenas acessados. Logo, não há quebra na integridade;
- Availability – None: os dados não são removidos, continuando disponíveis para uso. Logo, não há quebra na disponibilidade.
Diante deste cenário, já é possível afirmar que o CVSS sozinho não é eficaz para ser utilizado como medida ou recurso de priorizar adequadamente os seus processos de gestão de vulnerabilidades, como também é possível afirmar que o CVSS não é eficiente para avaliar vulnerabilidades de regras de negócio.
3. Metodologia
A proposta deste trabalho é um Modelo de Avaliação de Maturidade de Segurança em Aplicações, cujo seu resultado é uma nota de 0 a 10 a partir de um resultado de pentest.
O modelo proposto é composto por um submodelo que, através de algoritmos de aprendizado de máquina supervisionado, realiza a classificação de severidade/criticidade de vulnerabilidades através das métricas do CVSS em conjunto com o tipo/regra de negócio da empresa afetada. Esse submodelo tem como objetivo ajustar a classificação da vulnerabilidade em níveis de severidade, variando de 1 a 5, onde 1 corresponde a severidade classificada como informacional (info), 2 a baixa (low), 3 a média (medium), 4 a alta (high) e 5 a crítica (critical). Este submodelo permite adaptar a avaliação de vulnerabilidades ao contexto específico de cada empresa, proporcionando uma análise mais precisa e relevante para a priorização das ações de mitigação.
Com base nos resultados deste primeiro submodelo, é desenvolvido o modelo final, denominado Modelo de Avaliação de Maturidade de Segurança em Aplicações. Este modelo final utiliza a quantidade de vulnerabilidades por severidade e a quantidade de horas de um projeto para calcular uma nota final, representando a avaliação da maturidade em segurança, sendo esta de 0 a 10, onde 0 corresponde a maturidade muito baixa e 10 a maturidade muito alta. Esse modelo final também é elaborado por meio de aprendizado de máquina supervisionado, garantindo uma abordagem robusta e adaptativa para a avaliação da maturidade de segurança em aplicações.
Para ambos os modelos, foi utilizado de uma base de dados anonimizadas de uma empresa brasileira reconhecida no mercado de cibersegurança, sendo a base de dados para o modelo final incrementada e preenchida com os resultados do submodelo.
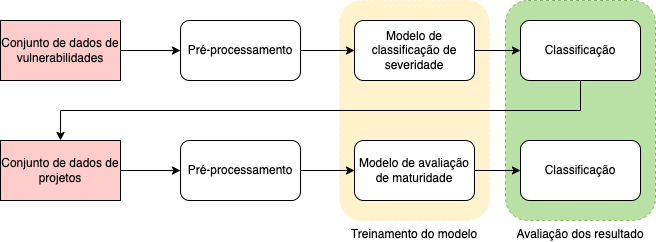
O ambiente utilizado para aplicação da metodologia foi a ferramenta Google Collaboratory e a estrutura idealizada para criação do modelo de avaliação de maturidade foi composta por sete etapas:
- Pré-processamento dos dados de vulnerabilidade;
- Treinamento do submodelo de classificação de severidade de uma vulnerabilidade;
- Avaliação dos resultados do submodelo treinado;
- A partir do resultado anterior, uma nova base de dados é gerada sendo esta o conjunto de vulnerabilidades de um projeto;
- Pré-processamento dos dados de projetos;
- Treinamento do modelo de avaliação de maturidade;
- Avaliação dos resultados do modelo treinado.
O esquema geral da estrutura é ilustrado na figura 12:
3.0.1 Pré-processamento dos dados
O pré-processamento dos dados é uma etapa fundamental antes da submissão dos dados para a etapa de treinamento. Dados rotulados e numéricos frequentemente apresentam distorções de faixas entre seus valores. É comum que seja necessário realizar transformações que compreendam a adição ou remoção de colunas e/ou a conversão de valores textuais ou rotulados para numéricos, bem como a transformação de dados numéricos para uma faixa específica de valores entre o valor mínimo e o máximo. A etapa de pré-processamento de dados foi realizada conforme os seguintes passos:
3.0.1.1 Conversão dos rótulos
Neste primeiro momento, foi realizado pré-processamento nos dados, simulando uma limpeza e normalização nos dados da base, onde foram definidos alguns valores específicos para os valores já existentes. As classes categóricas foram convertidas em valores numéricos e variáveis categóricas foram classificadas em uma representação numérica binária. A lista a seguir exemplifica como os valores foram classificados:
- A coluna denominada “Severidade” teve as seguintes substituições:
- Info recebeu o valor 0;
- Low recebeu o valor 1;
- Medium recebeu o valor 2;
- High recebeu o valor 3;
- Critical recebeu o valor 4.
- A coluna denominada “Classificação da empresa” teve as seguintes substituições:
- Healthcare recebeu o valor 1;
- Banking recebeu o valor 2;
- Financial Services recebeu o valor 3;
- Mass Media recebeu o valor 4;
- Information Technology recebeu o valor 5;
- Insurance recebeu o valor 6;
- Construction recebeu o valor 7;
- Food Processing recebeu o valor 8;
- Consulting recebeu o valor 9;
- Mining recebeu o valor 10;
- Education recebeu o valor 11;
- Pharmaceuticals recebeu o valor 12;
- Retail Sales recebeu o valor 13;
- Tourism recebeu o valor 14.
- Os valores da coluna denominada “CVSS Score” foram submetidos a uma função de normalização(minmaxscaler), para que todas as entradas estejam dentro de uma mesmo faixa de valores;
- As demais colunas e seus respectivos dados foram submetidos a função onehotencoder para converter variáveis categóricas em uma representação numérica binária.
3.1 Submodelo proposto – Classificação de severidade/criticidade
O primeiro passo para atingir o modelo desejado consistiu em construir um submodelo para possibilitar a classificação da severidade de uma vulnerabilidade de acordo com o tipo de negócio do cliente. Este submodelo utilizou exclusivamente os dados de métrica do CVSS e do tipo de negócio do cliente, considerando que o CVSS por si só não é capaz de fornecer uma classificação totalmente assertiva. A inclusão do tipo de negócio permite uma avaliação mais contextualizada e precisa, ajustando a criticidade das vulnerabilidades conforme a relevância e impacto específicos para cada organização. Dessa forma, o submodelo foi desenvolvido para aprimorar a precisão das classificações de severidade, facilitando a adaptação das estratégias de mitigação às particularidades de cada cliente. Este submodelo, após ser devidamente treinado e validado, serviu como base para a construção do modelo final de avaliação de maturidade de segurança.
3.1.1 Conjunto de dados
Para a criação e validação do submodelo em questão, seja na verificação da acurácia, na identificação do melhor modelo de classificação ou na determinação dos pesos das variáveis do modelo, utilizou-se uma base de dados anonimizados de uma empresa brasileira reconhecida no mercado de cibersegurança. Esta base de dados contém 1.300 entradas, sendo cada entrada uma vulnerabilidade real existente em aplicações e sistemas reais do cenário brasileiro e internacional, reportadas para as empresas solicitantes dos projetos de pentest. Cada vulnerabilidade foi classificada manualmente por um analista, consultor ou especialista em segurança da informação e revisada por outros analistas, consultores ou especialistas para averiguar sua classificação correta. Os dados foram categorizados e contêm os seguintes campos:
- ID do projeto:
- número inteiro positivo (ou índice);
- Classificação da empresa:
- rótulo de classificação de um conjunto de 14 dados;
- CVSS Score:
- número inteiro positivo de 0 a 10, com uma casa decimal de 0 a 9;
- Attack Vector (AV):
- rótulo de classificação, denominado como “N” (Network), “A” (Adjacent), “L” (Local) ou “P” (Physical);
- Attack Complexity (AC):
- rótulo de classificação, denominado como “L” (Low) ou “H” (High);
- Privileges Required (PR):
- rótulo de classificação, denominado como “N” (None), “L” (Low) ou “H” (High);
- User Interaction (UI):
- rótulo de classificação, denominado como “N” (None) ou “R” (Required) ;
- Scope (S):
- rótulo de classificação, denominado como “U” (Unchanged) ou “C” (Changed);
- Confidentiality (C):
- rótulo de classificação, denominado como “N” (None), “L” (Low) ou “H” (High);
- Integrity (I):
- rótulo de classificação, denominado como “N” (None), “L” (Low) ou “H” (High);
- Availability (A):
- rótulo de classificação, denominado como “N” (None), “L” (Low) ou “H” (High);
- Severidade:
- rótulo de classificação, denominado como Info, Low, Medium, High ou Critical.
3.1.2 Treinamento do modelo
Para realização do treinamento do modelo, os dados foram particionados aleatoriamente em dois segmentos, sendo 70% — totalizando 910 entradas — das amostras alocadas para o treinamento e 30% — totalizando 390 entradas — reservadas para testes.
Após o pré-processamento e a divisão dos dados, o próximo passo consistiu em realizar o levantamento de quais modelos de classificação supervisionada se comportam melhor para a modelagem em questão. Foram feitos levantamentos estatísticos de 10 (dez) dez modelos de classificação para treinamento e comparação de acurácia. A ideia dessa etapa foi identificar qual modelo se encaixaria melhor com o problema. A lista a seguir informa quais algoritmos de classificação foram utilizados:
- Extra Trees;
- Random Forest;
- Gradient Boosting;
- AdaBoost;
- Logistic Regression;
- MLP;
- GaussianNB;
- SVC;
- K-Neighbors;
- XGBoost.
Cada algoritmo, disponibilizado pela biblioteca SciKit Learn, foi treinado e avaliado em 5000 iterações, garantindo a variabilidade e robustez dos resultados. O processo foi paralelizado utilizando a biblioteca threading do Python, distribuindo as iterações em 50 threads por algoritmo. Cada algoritmo foi avaliado utilizando a média, f1-score, revocação e desvio padrão da acurácia. A escolha desses algoritmos foi baseada em suas distintas abordagens e popularidade na literatura, proporcionando uma ampla gama de técnicas de aprendizado supervisionado para a comparação.
3.2 Modelo Proposto – Avaliação e Classificação de Projeto
A partir do submodelo de classificação de severidade de uma vulnerabilidade — conforme descrito anteriormente —, o próximo passo consistiu na geração do modelo de avaliação de maturidade de segurança do sistema submetido ao projeto de pentest como um todo. Este processo envolveu o agrupamento de todas as vulnerabilidades classificadas pelo submodelo anterior para obter a nota final da avaliação de segurança de um determinado projeto. O modelo de avaliação de maturidade foi desenvolvido para categorizar a nota de um projeto em cinco níveis distintos, considerando a quantidade de horas de execução e a quantidade de itens classificados e categorizados pelo submodelo inicial. A partir do resultado do modelo, as notas de maturidade de segurança de uma aplicação poderiam ser categorizadas da seguinte forma:
- Muito Baixa:
- Nota de 0.0 a 2.0 (0.0 <= nota <= 2.0);
- Baixa:
- Nota de 2.0 a 4.0 (2.0 < nota <= 4.0);
- Média:
- Nota de 4.0 a 6.0 (4.0 < nota <= 6.0);
- Alta:
- Nota de 6.0 a 8.0 (6.0 < nota <= 8.0);
- Muito Alta:
- Nota de 8.0 a 10.0 (8.0 < nota <= 10.0).
3.2.1 Conjunto de dados
Para a criação e validação do modelo final em questão, seja na verificação da acurácia, na identificação do melhor modelo de classificação ou na determinação dos pesos das variáveis do modelo, utilizou-se uma base de dados anonimizados de uma empresa brasileira reconhecida no mercado de cibersegurança. Esta base de dados contém 783 entradas, onde cada entrada representa um projeto de pentest real em uma aplicação e sistema real do cenário brasileiro e internacional, reportado para as empresas solicitantes de tais projetos. Cada projeto foi executado manualmente por um analista, consultor ou especialista em segurança da informação e a sua documentação foi revisada por outros analistas, consultores ou especialistas para averiguar sua classificação correta. Os dados foram categorizados e contêm os seguintes campos:
- ID do projeto:
- número inteiro positivo (ou índice);
- Horas do Projeto:
- número inteiro positivo múltiplo de 40, limitado entre 40 e 240;
- Classificação da Empresa:
- rótulo de classificação de um conjunto de 14 dados;
- Quantidade_Info:
- número inteiro maior ou igual a 0;
- Quantidade_Low:
- número inteiro maior ou igual a 0;
- Quantidade_Medium:
- número inteiro maior ou igual a 0;
- Quantidade_High:
- número inteiro maior ou igual a 0;
- Quantidade_Critical:
- número inteiro maior ou igual a 0;
- Nota do Projeto:
- número inteiro positivo de 0 a 10, com uma casa decimal de 0 a 9.
3.2.2 Treinamento do modelo
Para realização do treinamento do modelo, os dados foram particionados aleatoriamente em dois segmentos, sendo 70% — totalizando 548 entradas — das amostras alocadas para o treinamento e 30% — totalizando 235 entradas — reservadas para testes.
Após o pré-processamento e a divisão dos dados, o próximo passo consistiu em realizar o levantamento de quais modelos de classificação supervisionada se comportam melhor para a modelagem em questão. Foram feitos levantamentos estatísticos de 10 (dez) modelos de classificação para treinamento e comparação de acurácia. A ideia dessa etapa foi identificar qual modelo se encaixaria melhor com o problema. A lista a seguir informa quais algoritmos de classificação foram utilizados:
- Random Forest
- Logistic Regression
- K-Nearest Neighbors
- Support Vector Machine
- Gradient Boosting
- Decision Tree
- Naive Bayes
- AdaBoost
- Extra Trees
- XGBoost
Cada algoritmo, disponibilizado pela biblioteca SciKit Learn, foi treinado e avaliado em 5000 iterações, garantindo a variabilidade e robustez dos resultados. O processo foi paralelizado utilizando a biblioteca threading do Python, distribuindo as iterações em 50 threads por algoritmo. Cada algoritmo foi avaliado utilizando a média, f1-score, revocação e desvio padrão da acurácia. A escolha desses algoritmos foi baseada em suas distintas abordagens e popularidade na literatura, proporcionando uma ampla gama de técnicas de aprendizado supervisionado para a comparação.
4. Resultados
4.1 Avaliação dos resultados – submodelo de classificação de severidade
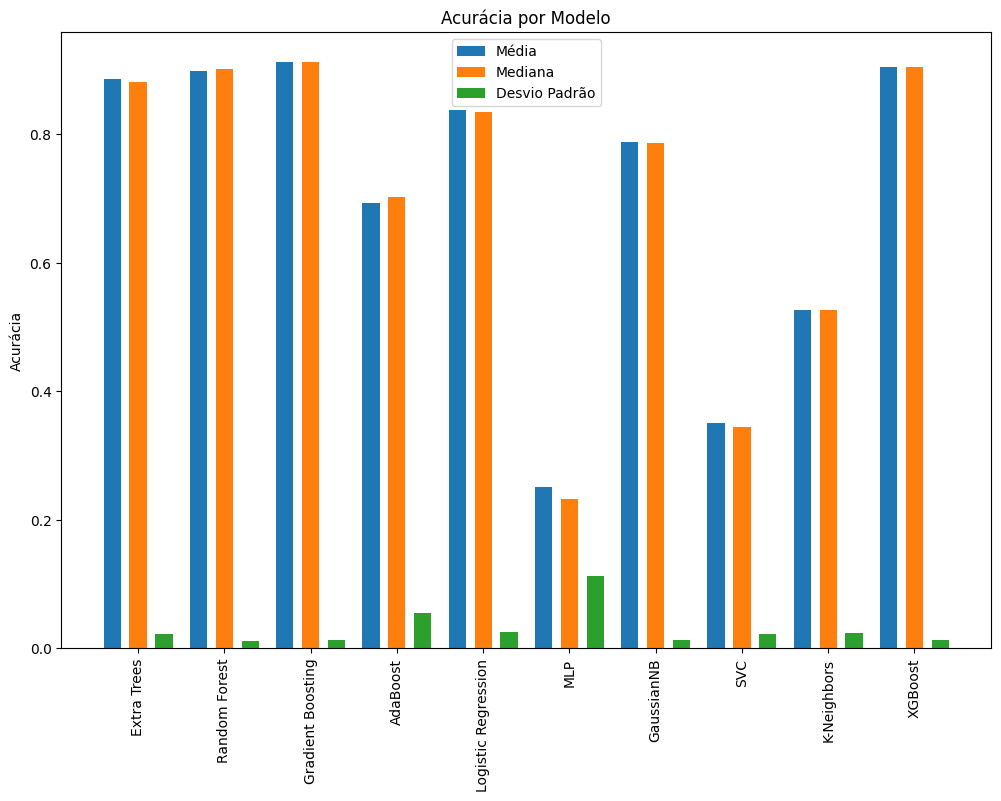
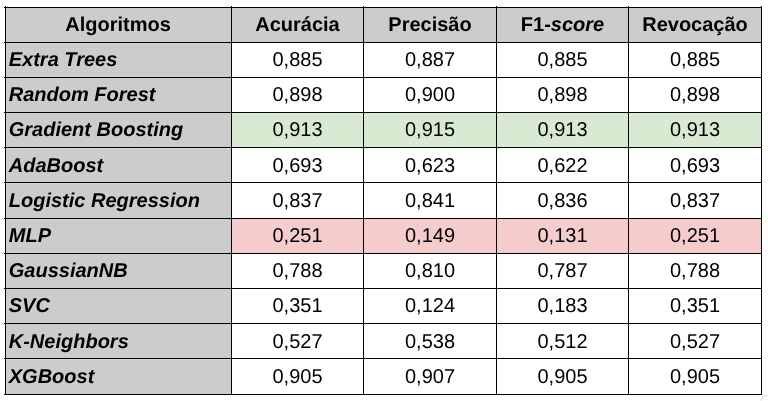
As submissões indicaram que o algoritmo Gradient Boosting apresentou o melhor desempenho, com uma acurácia média de 91% ao classificar as vulnerabilidades em cinco categorias distintas, sendo um desempenho comparável ao algoritmo XGBoost que apresentou uma acurácia de 90%. A robustez do modelo foi corroborada pelo baixo desvio padrão das métricas de desempenho, indicando consistência ao longo das iterações. A figura 14 ilustra os dados descritos anteriormente.
Os resultados para cada algoritmo utilizado neste estudo podem ser visualizados através da tabela 1. É possível observar, em um primeiro momento, a discrepância dos resultados entre o algoritmo Gradient Boosting e MLP (multilayer perception). Também é possível observar que os demais algoritmos tiveram um desempenho equivalente entre si.
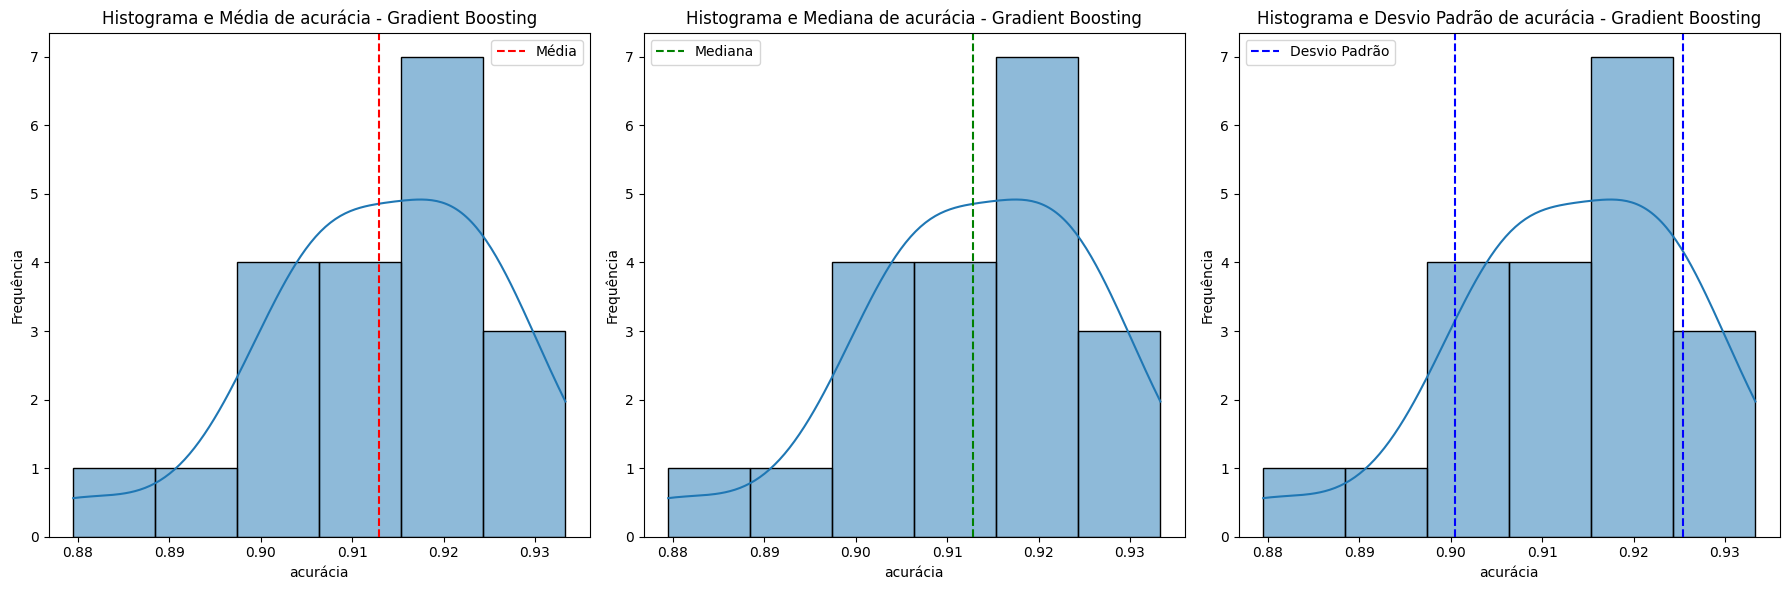
É possível analisar os dados da acurácia do algoritmo destacado positivamente para o modelo em questão através da figura 15.
Também foi possível analisar os resultados através de uma matriz de confusão, a qual permite a visualização das previsões corretas e incorretas do modelo. Os resultados da matriz de confusão para o algoritmo Gradient Boosting, utilizado na classificação da severidade de vulnerabilidades, são apresentados na figura 16.
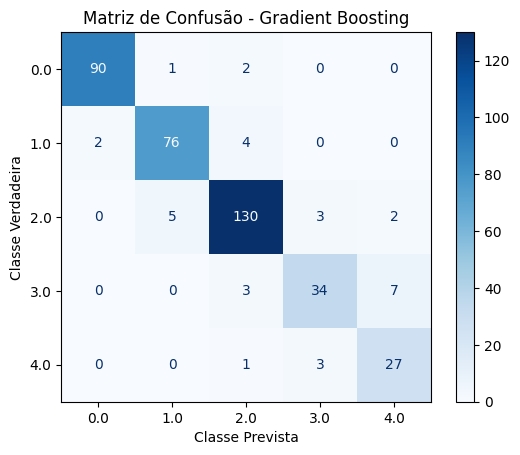
A partir da matriz de confusão, é possível concluir que:
- Classe 0 (severidade Info):
- O modelo previu corretamente 90 entradas de dados da classe 0, com apenas 3 predições incorretas (1 instância classificada como 1 e 2 instâncias como 2).
- Classe 1 (severidade Low):
- Para a classe 1, o modelo fez 76 predições corretas, com 6 erros (2 instâncias classificadas como 0 e 4 instâncias como 2).
- Classe 2 (severidade Medium):
- A classe 2 teve o maior número de instâncias corretamente previstas, totalizando 130, com 10 erros de classificação (5 instâncias classificadas como 1, 3 como 3 e 2 como 4).
- Classe 3 (severidade High):
- O modelo previu corretamente 34 instâncias da classe 3, com 10 predições incorretas (3 instâncias classificadas como 2 e 7 instâncias como 4).
- Classe 4 (severidade Critical):
- Para a classe 4, houve 27 predições corretas e 4 erros (1 instância classificada como 2 e 3 instâncias como 3).
4.2 Avaliação dos resultados – modelo de classificação de projeto
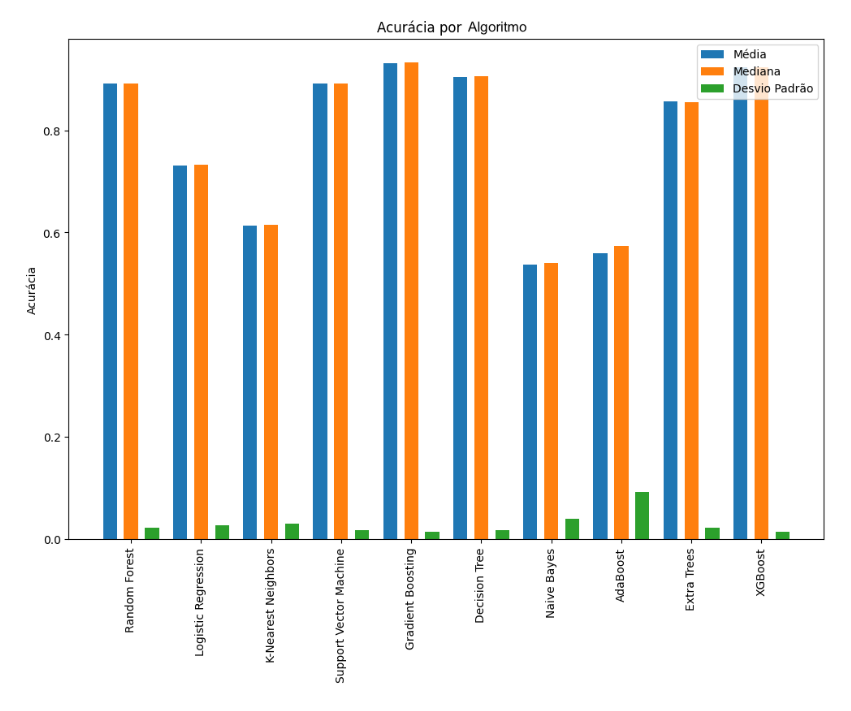
As submissões indicaram que o algoritmo Gradient Boosting apresentou o melhor desempenho, com uma acurácia média de 93% ao classificar os projetos em cinco categorias distintas, sendo um desempenho comparável ao algoritmo XGBoost que apresentou uma acurácia de 92%. A robustez do modelo foi corroborada pelo baixo desvio padrão das métricas de desempenho, indicando consistência ao longo das iterações. A figura 17 ilustra os dados descritos anteriormente.
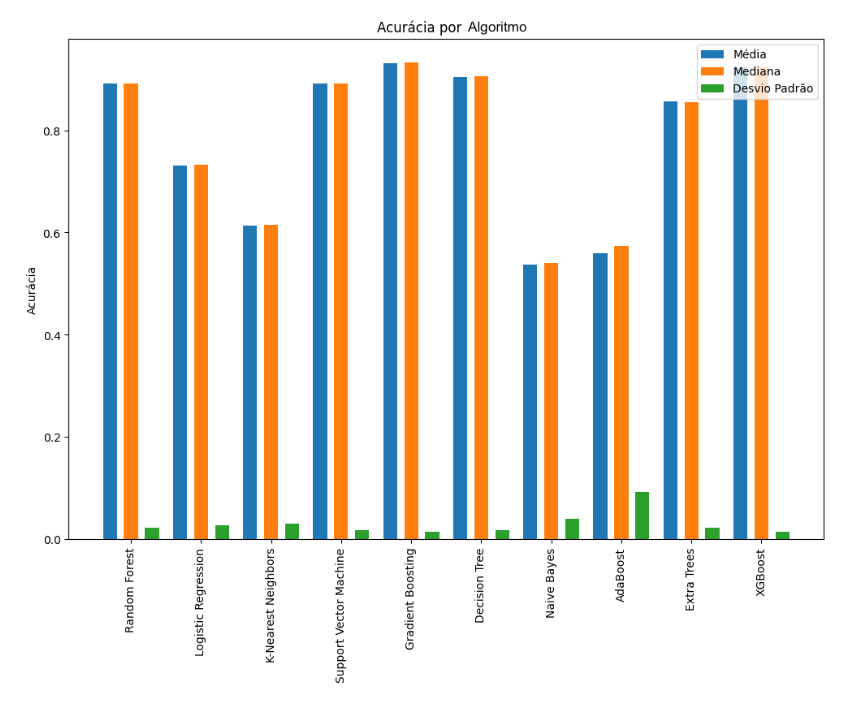
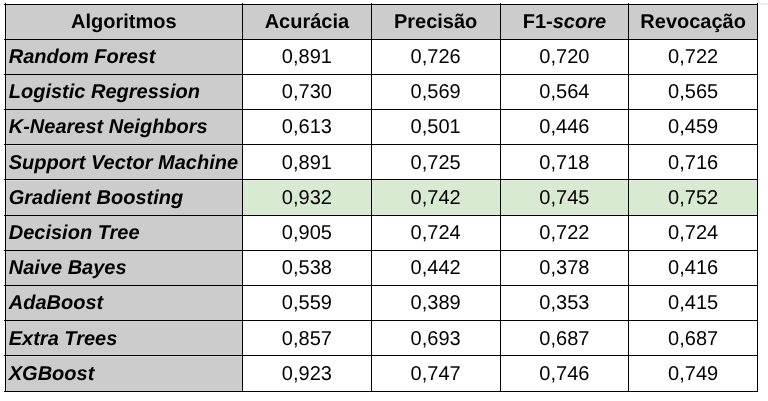
Os resultados para cada algoritmo utilizado neste estudo podem ser visualizados através da tabela 2. É possível observar, em um primeiro momento, que os algoritmos tiveram uma média de resultados bem parecidos, não tendo uma diferença tão discrepante em comparação aos resultados do submodelo anterior.
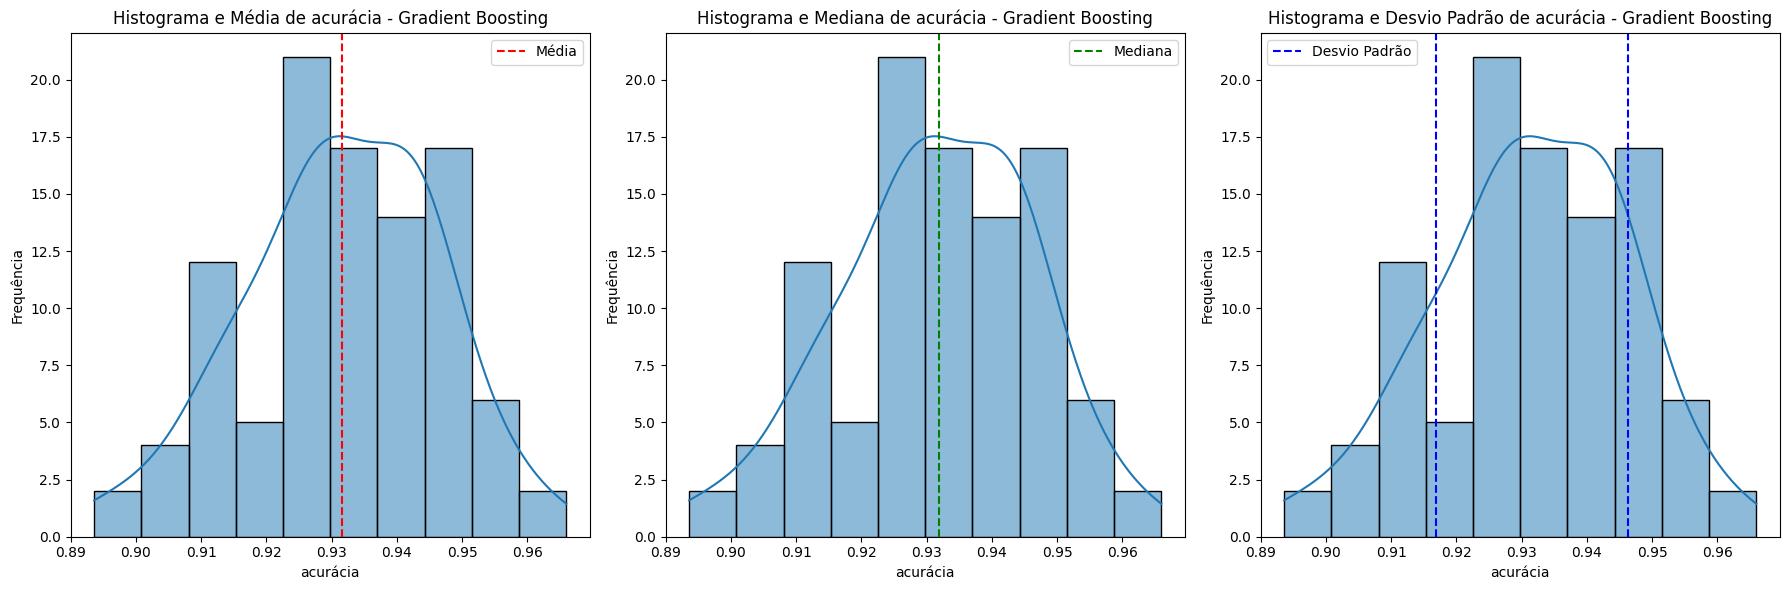
É possível analisar os dados da acurácia do algoritmo destacado através da imagem 18:
Também foi possível analisar os resultados através de uma matriz de confusão, a qual permite a visualização das previsões corretas e incorretas do modelo. Os resultados da matriz de confusão para o algoritmo Gradient Boosting, utilizado na classificação do nível de maturidade dos projetos, são apresentados na figura 19:
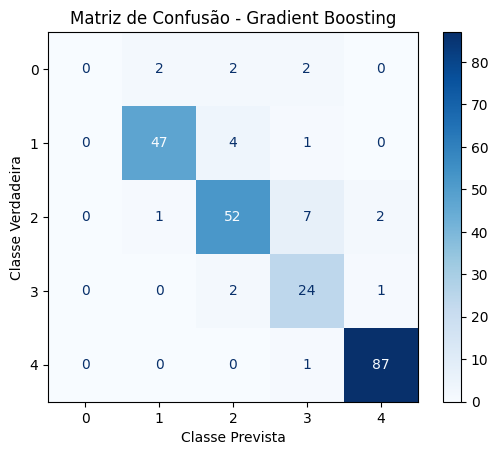
A partir da matriz de confusão obtida, é possível concluir como resultado:
- Classe 0 (maturidade muito baixa – nota entre 0.0 e 2.0):
-
- O modelo apresenta dificuldades significativas para prever corretamente a classe 0, com nenhuma previsão correta. Isso indica que o modelo não está capturando bem as características dessa classe, ou que há um desequilíbrio significativo na quantidade de dados dessa classe.
- Classe 1 (maturidade baixa – nota entre 2.1 e 4.0):
-
- O modelo tem um desempenho razoável com 47 previsões corretas, mas ainda apresenta algumas confusões com classes 2 e 3, sugerindo que as características dessas classes podem ser semelhantes ou que o modelo não está suficientemente ajustado para diferenciá-las.
- Classe 2 (maturidade média – nota entre 4.1 e 6.0):
-
- O modelo prevê bem a classe 2 com 52 previsões corretas, mas há uma notável confusão com as classes 1 e 3. Isso pode indicar que as classes 1, 2 e 3 possuem características sobrepostas ou que o modelo pode ser melhorado para diferenciar essas classes.
- Classe 3 (maturidade alta – nota entre 6.1 e 8.0):
-
- O desempenho é razoável com 24 previsões corretas, mas há pequenas confusões com a classe 2. Isso pode ser esperado em classes com transições suaves e características semelhantes.
- Classe 4 (maturidade muito alta – nota entre 8.1 e 10.0):
-
- O modelo apresenta um excelente desempenho para a classe 4, com 87 previsões corretas e apenas uma confusão com a classe 2. Isso sugere que a classe 4 possui características bem definidas que o modelo consegue capturar eficazmente.
Também é possível afirmar que a maioria dos projetos analisados indicam que seus respectivos sistemas (seja esse uma aplicação web ou mobile) possuem uma maturidade de segurança ou mediana ou muito alta.
Os resultados mostram que o algoritmo Gradient Boosting apresenta um excelente desempenho na classificação das classes de severidade de vulnerabilidades. O modelo tem alta acurácia, especialmente para as classes Info (0), Low (1) e Medium (2), comuns em projetos de pentest.
A taxa de falsos-positivos e falsos-negativos é baixa, e, quando ocorre, geralmente entre classes adjacentes, sugerindo que dados mal classificados têm características similares. A performance do modelo é consistente, com poucas variações entre as classes, indicando boa generalização do algoritmo, reforçando a viabilidade do uso do Gradient Boosting para classificar a severidade de vulnerabilidades.
5. Conclusão
Os resultados obtidos com o uso do Gradient Boosting sugerem que o modelo é eficaz na avaliação de maturidade de segurança, especialmente para classes de maturidade alta e muito alta. No entanto, a precisão para a classe de maturidade muito baixa e baixa é insatisfatória, destacando a necessidade de ajustes adicionais ou de uma maior quantidade de dados específicos para estas classes. Tal fato pode ocorrer principalmente pelo fato de não existir um limiar de nota zero para uma determinada maturidade de segurança de uma aplicação, uma vez que a mesma pode ter de zero a infinitas vulnerabilidades.
A performance consistente do modelo, evidenciada pelo baixo desvio padrão das métricas de desempenho, reforça a viabilidade do uso de algoritmos de aprendizado de máquina na classificação de maturidade de segurança em projetos de pentests.
5.1 Trabalhos futuros
Os resultados dessa pesquisa forneceram uma base para a avaliação de maturidade de segurança de um sistema a partir de um projeto de pentest utilizando técnicas de aprendizado supervisionado. No entanto, há diversos caminhos promissores para trabalhos futuros que podem aprimorar e expandir os resultados obtidos. Algumas dessas ideias são descritas a seguir:
- Adicionar o CWE nas variáveis de classificação de severidade/criticidade:
Adicionar a Common Weakness Enumeration (CWE) como uma variável adicional pode enriquecer o modelo. CWE fornece uma classificação detalhada de tipos de vulnerabilidades, que pode ser particularmente útil na análise de projetos de segurança e pentest.
- Atualizar o modelo para novas versões do CVSS:
Atualizar ou ajustar o modelo desenvolvido neste estudo para utilizar o CVSS 4.0, ou qualquer outra versão mais nova, permitiria incorporar as melhorias e novas métricas introduzidas na versão mais recente do sistema de pontuação, garantindo que o modelo se mantenha alinhado com as práticas e padrões mais atuais da indústria de segurança da informação.
- Identificação de Novas Variáveis Relevantes:
Explorar outras variáveis que possam ser relevantes em um contexto de projeto de pentest pode ajudar a melhorar a precisão do modelo. Variáveis como o tipo de teste realizado (teste de intrusão, análise estática de código, etc.), a experiência do time de pentest, tamanho do escopo e a criticidade do sistema avaliado podem favorecer uma melhor precisão no modelo.
- Aprimoramento da Acurácia e Precisão:
Embora o modelo Random Forest tenha apresentado um bom desempenho, sempre há espaço para melhorias na acurácia e precisão da classificação.
- Integração com Sistemas de Gestão de Vulnerabilidades
Integrar o modelo de classificação com sistemas de gestão de vulnerabilidades existentes pode facilitar a automação e a aplicação prática dos resultados do modelo.
- Análise de hiperparâmetros
Realizar uma análise detalhada dos hiperparâmetros utilizados no modelo deste artigo. Este estudo futuro buscará identificar os hiperparâmetros que mais impactam a eficácia do modelo e otimizar suas configurações para maximizar a precisão e a eficiência das avaliações.
6. Referências
[ARCOVERDE 2013] ARCOVERDE, H. F. (2013). Malwares brasileiros: técnicas, alvos e tendências. Master’s thesis, Universidade Federal de Pernambuco.
[Assad et al. 2011] Assad, R., Ferraz, F., Arcoverde, H., Romero, S., and Meira, L. (2011). Security quality assurance on web applications. Journal of Software Engineering Advances. doi, pages 978–1.
[FIRST.org ] FIRST.org. Common vulnerability scoring system (CVSS). Acesso em: 10 abril 2024.
[FIRST.org 2019] FIRST.org (2019). Cvss v3.1 specification document. Acesso em: 10 abril 2024.
[MITRE ] MITRE. Common weakness enumeration (CWE). Acesso em: 26 maio 2024.
[Pedregosa et al. 2011] Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., and Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12:2825–2830.
[PortSwigger a] PortSwigger. Horizontal privilege escalation. Acesso em: 26 maio 2024.
[PortSwigger b] PortSwigger. Idor. Acesso em: 26 maio 2024.
[scikit learn a] scikit learn. Decision tree. Acesso em: 20 abril 2024.
[scikit learn b] scikit learn. Gaussiannb. Acesso em: 20 abril 2024.
[scikit learn c] scikit learn. Mlpclassifier. Acesso em: 20 abril 2024.
[scikit learn d] scikit learn. Svc. Acesso em: 20 abril 2024.
[scikit learn a] scikit learn. Adaboostclassifier. Acesso em: 14 abril 2024.
[scikit learn b] scikit learn. Extratreesclassifier. Acesso em: 14 abril 2024.
[scikit learn c] scikit learn. Gradientboostingclassifier. Acesso em: 14 abril 2024.
[scikit learn d] scikit learn. Kneighborsclassifier. Acesso em: 13 abril 2024.
[scikit learn e] scikit learn. Logisticregression. Acesso em: 13 abril 2024.
[scikit learn f] scikit learn. Minmaxscaler. Acesso em: 13 abril 2024.
[scikit learn g] scikit learn. Naive Bayes. Acesso em: 14 abril 2024.
[scikit learn h] scikit learn. Onehotencoder. Acesso em: 13 abril 2024.
[scikit learn i] scikit learn. Randomforestclassifier. Acesso em: 13 abril 2024.
[scikit learn j] scikit learn. Support vector machines (SVM). Acesso em: 14 abril 2024.
[Spring et al. 2021] Spring, J., Hatleback, E., Householder, A., Manion, A., and Shick, D. (2021). Time to change the CVSS? IEEE Security Privacy, 19(2):74–78.
[XGBoost ] XGBoost. Xgboost documentation. Acesso em: 20 abril 2024.
¹ exploit: software ou código malicioso que explora uma falha ou vulnerabilidade relacionada a um ativo, seja esse um sistema, software ou hardware de um computador;
² Insecure Direct Object Reference (IDOR): vulnerabilidade que permite que os atacantes acessem ou modifiquem objetos ao manipular identificadores utilizados nas URLs ou parâmetros;
³ Escalação horizontal de privilégios: ocorre quando um usuário consegue acessar recursos pertencentes a outro usuário do mesmo perfil de acesso, em vez de seus próprios recursos.

Assine a nossa Newsletter